MotionBoardのPowerPointレポート出力機能を編集画面から紹介する
Ryosuke Ishii
データパレード
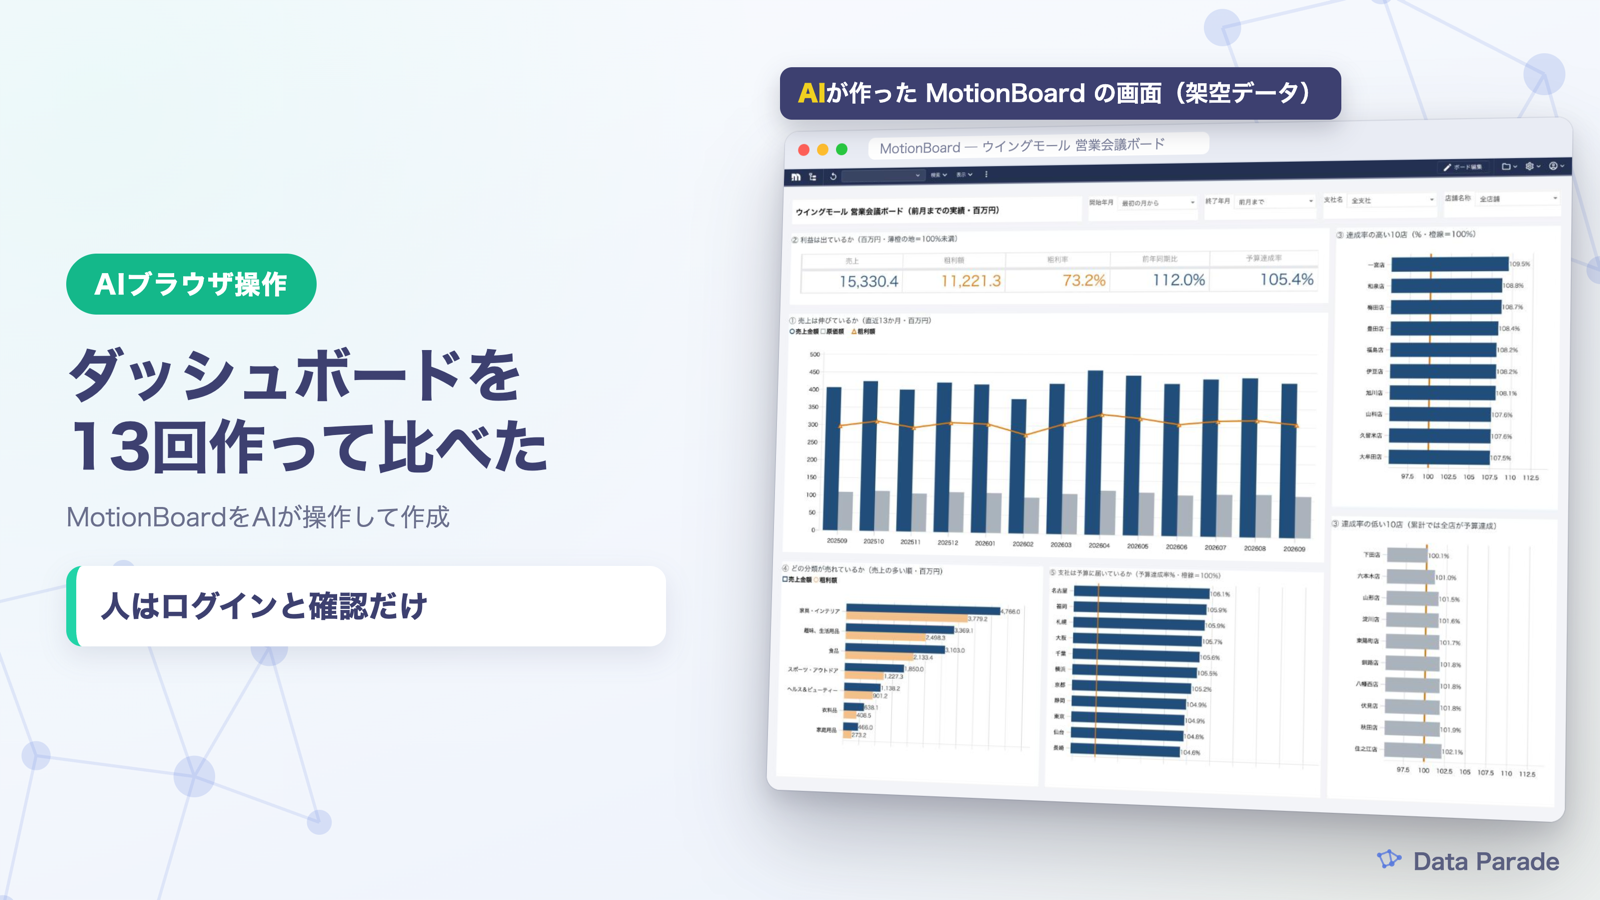
「AIにダッシュボードを作ってもらう」は、どこまで本当にできるのか。MotionBoard re:Actの画面をClaudeがブラウザ越しに操作し、ボードを一から作る検証をしました。モデルの違い、渡す資料の違いで出来がどう変わるか、作業時間と使用量はどれくらいか。13回作って比べた結果を書きます。
この記事は、弊社が自社の環境で試した記録です。MotionBoard の開発元のメーカーが出している公式の手順ではありません。ボードは MotionBoard の画面の操作だけで作り、ボード定義のファイルを直接書き換えることはしていません。
AIブラウザ操作とは:AI がブラウザの画面を読み取り、人と同じようにクリックや文字の入力をして、Web のアプリを操作することです。この記事では、データパレードがこの方法で MotionBoard を操作した検証を、「AIブラウザ操作」と呼んでいます。開発元のメーカーが提供する AI の機能とは別のものです。
Claude in Chrome とは:Anthropic 社の AI「Claude」を、Google Chrome の拡張機能として動かす仕組みです。Claude が開いているページの内容を読み、クリック・入力・画面の切り替えを行います。今回の検証では、ログインは人が行い、その後の操作を Claude in Chrome で行いました。
ダッシュボードを作る仕事は、データの確認、画面の割り付け、部品の配置、色や書式の調整、数字の検算と、手順は決まっているのに手間がかかります。1つのボードに、数時間から数日かかることもあります。
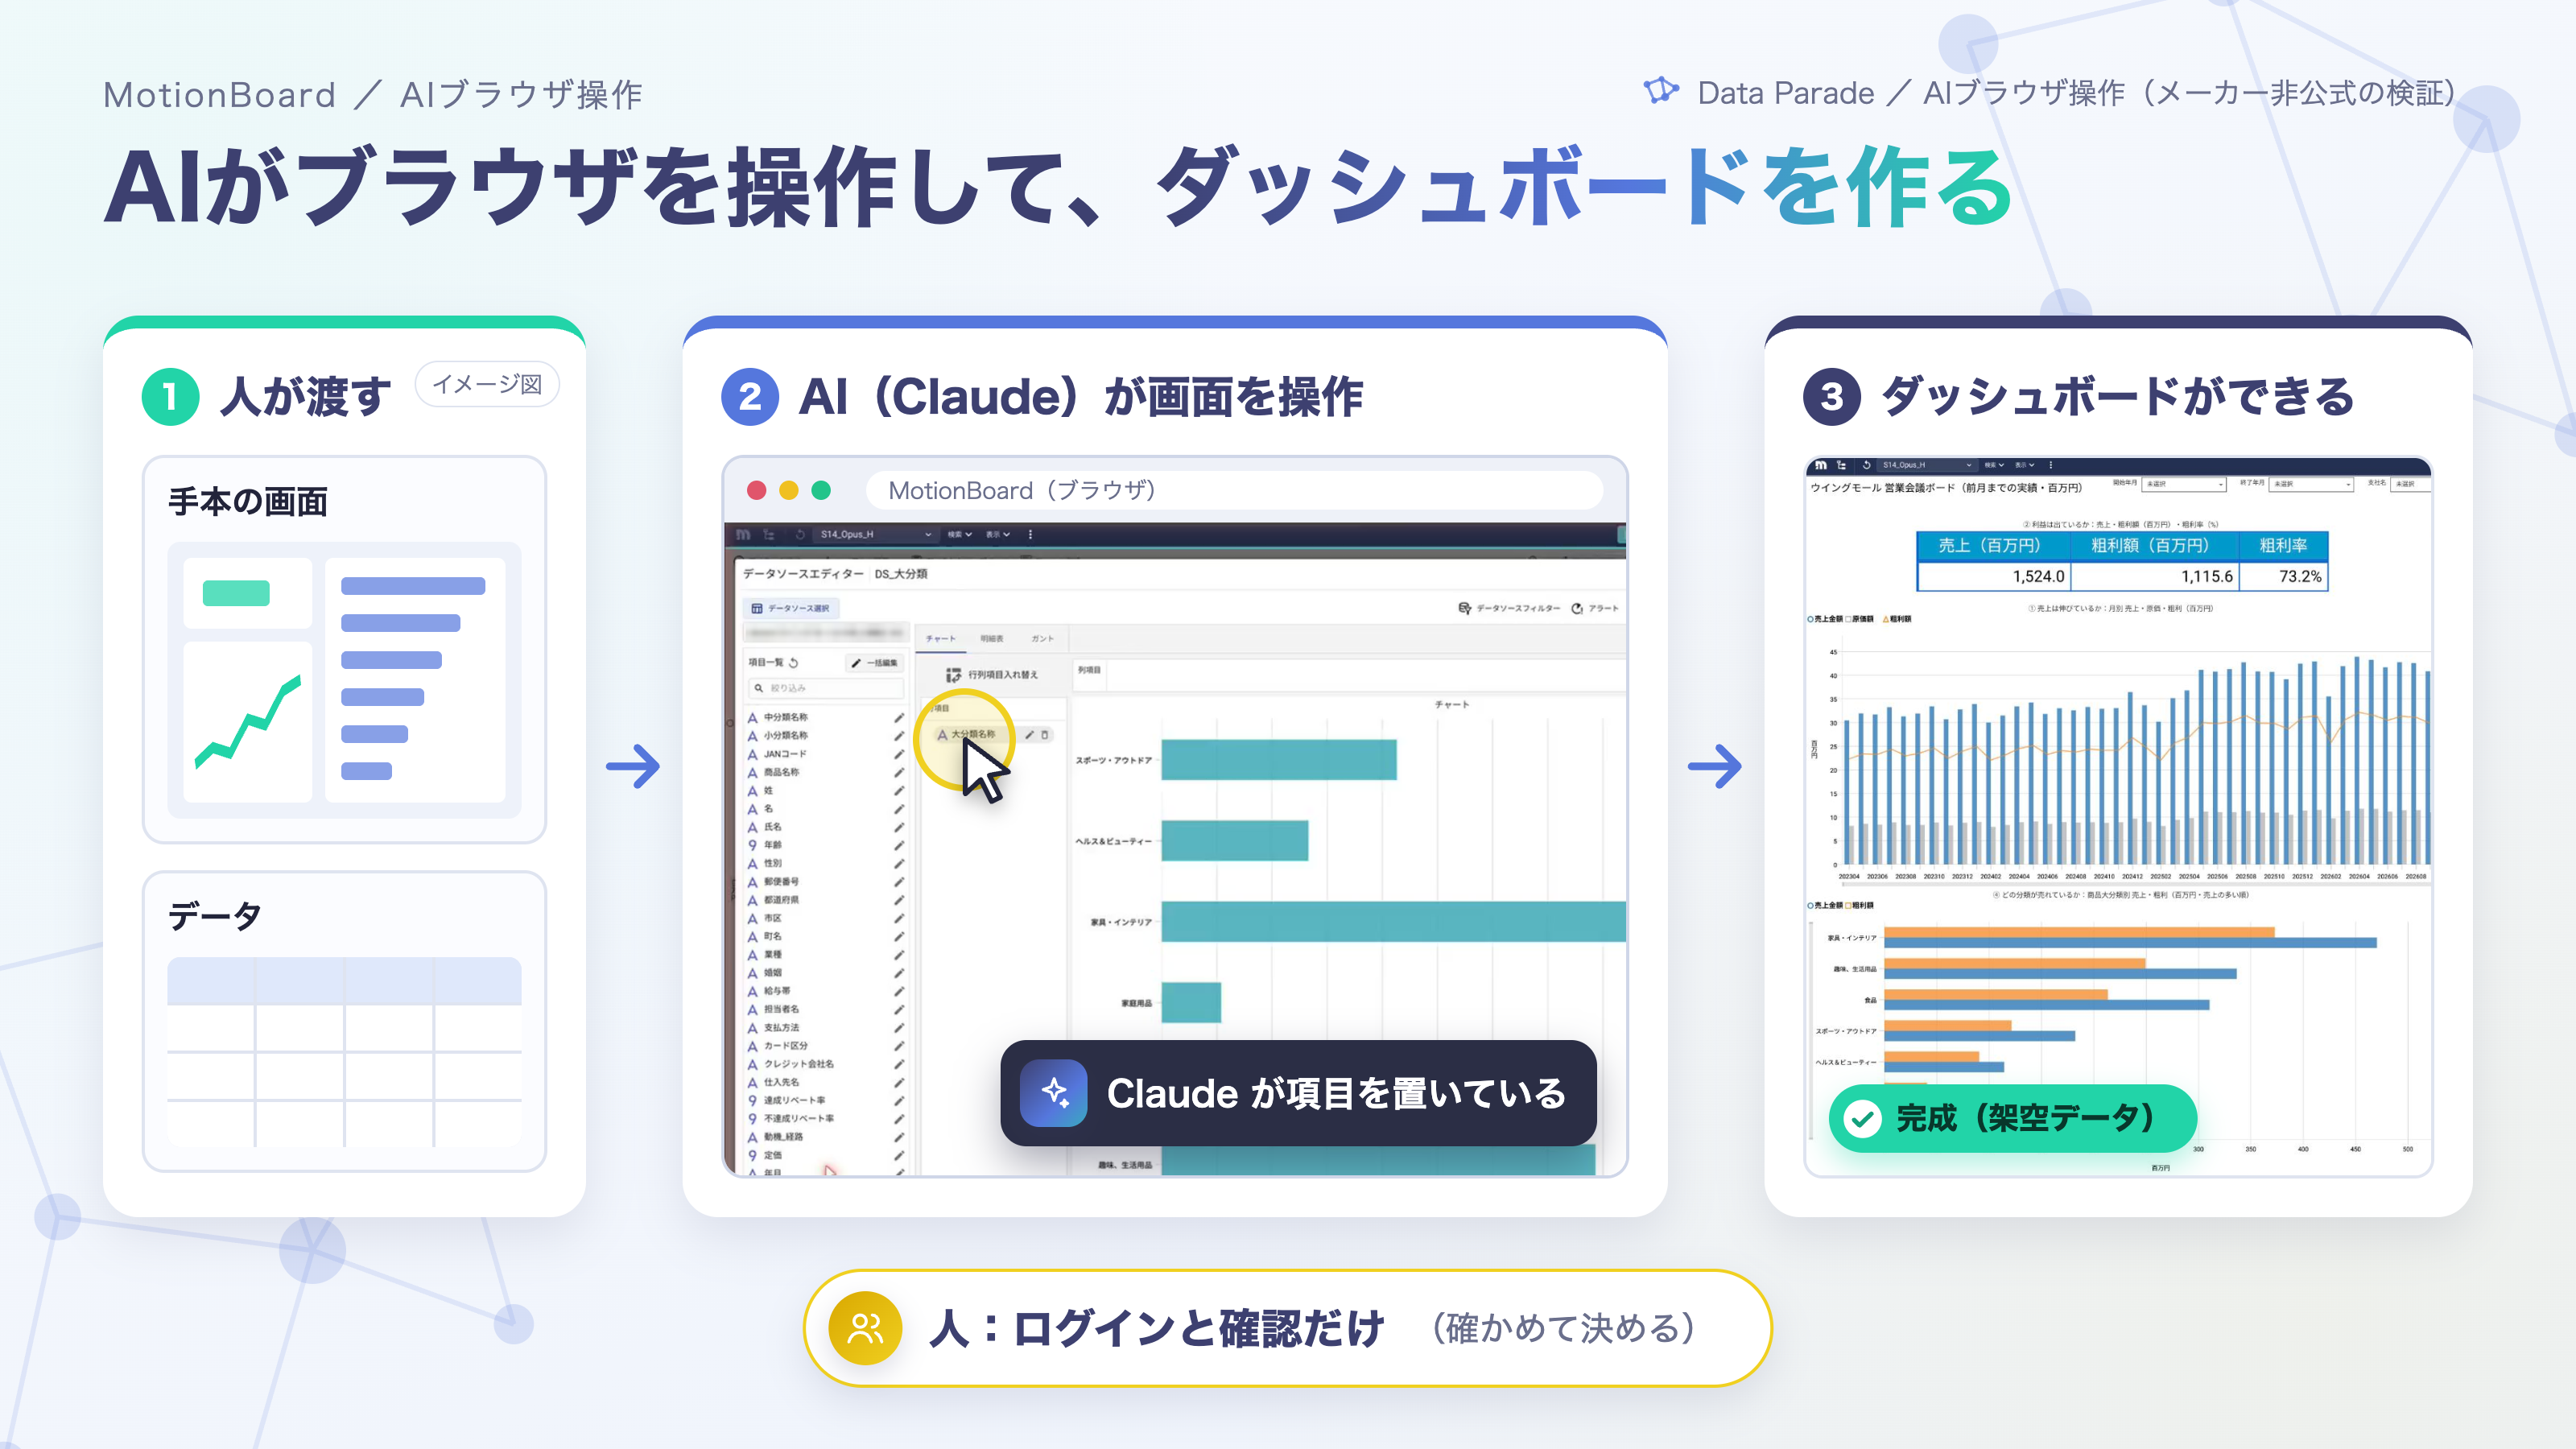
AIブラウザ操作で目指しているのは、次のような形です。
この記事は、そこへ向けて、今どこまで AI に任せられて、どこで人の手が要るかを確かめた記録です。
結論
- 同じ6条件で比べると、Opus 5.5 は平均90点、Sonnet 5.5 は平均68点。データの読み違いに気づいた回数と、作った画面を見直す時間にも差があった
- デジタル庁のダッシュボードデザインガイドブックを渡した回が、どちらのモデルでも最高点(Opus はメーカーのデザインコンテンツを渡した回と同点)。資料を全部渡した回は、どちらのモデルでもガイドブックだけの回を下回った
- 13回の結果を教材にして作り直すと100点。さらに予算・前年比較まで足すと、AIは使っていたデータが本物の10分の1だと自分で見抜いた
お題は全回同じです。
小売チェーンの営業部長が、月初の営業会議で前月までの売上の状況をつかむために、5分で見るダッシュボード。知りたいのは、売上の推移、利益が出ているか、どの店が良くて悪いか、どの分類が売れているか、気になる店・期間に絞り込めるか、の5つ。
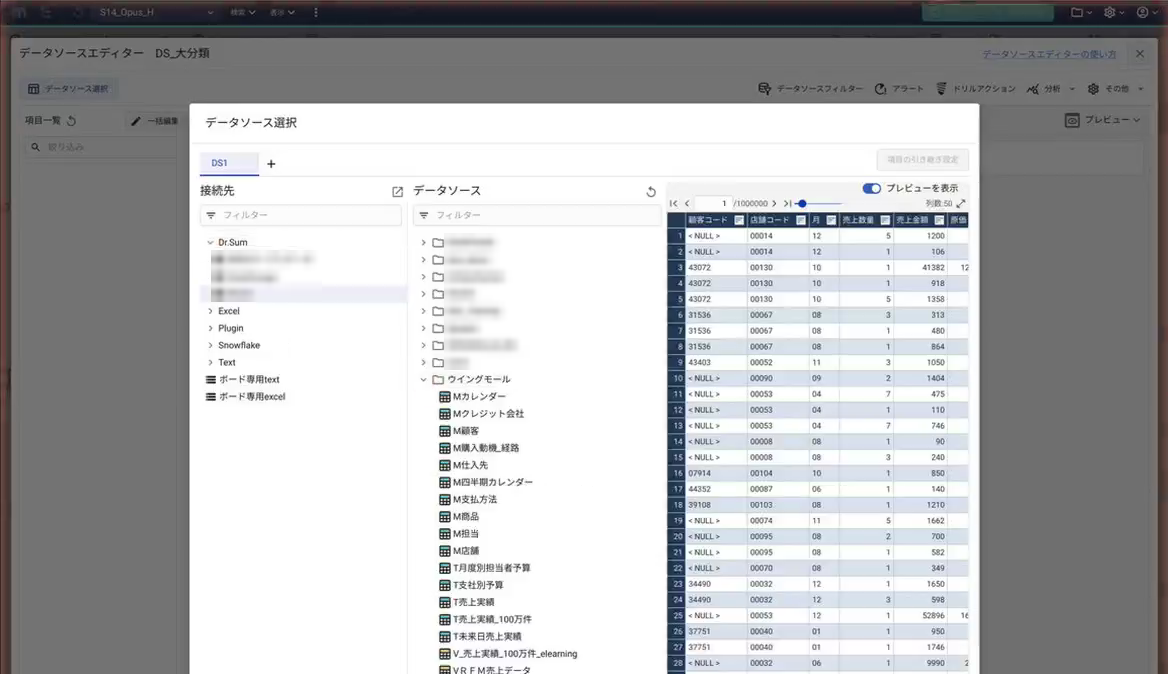
データは Dr.Sum に入っている製品付属のサンプル「ウイングモール」の売上実績(100万件)です。Claude は Claude in Chrome(ブラウザを操作する拡張機能)で MotionBoard re:Act の画面を開き、人と同じようにクリックと入力でボードを作ります。人はログインだけを行い、作業中は手を出しません。
条件は次の6つ。各条件を Opus 5.5 と Sonnet 5.5 で1回ずつ、くじで決めた順番で実施しました。
| 条件 | 渡したもの |
|---|---|
| A 依頼文だけ | お題のみ |
| B マニュアル付き | MotionBoard のオンラインマニュアル11ページのURL |
| C 構想先行 | 作り始める前に完成図を文章で決める指示 |
| D デザインガイド付き | デジタル庁「ダッシュボードデザイン実践ガイドブック」(PDF) |
| E 全部入り | B+C+D+F |
| F メーカーのデザイン付き | 開発元のメーカーが公開している「MotionBoardデザインコンテンツ」11ページのURL |
これに加えて、Opus で「全資料を読み、先にデータを確かめ、完成図を決めてから作る」最高パターン(G)を1回行いました。G はくじ引きの外なので、モデルや条件の平均には入れていません。
| 項目 | 配点 | 見方 |
|---|---|---|
| 見た目 | 65 | 完成画面1枚を、どの回か伏せて Claude と ChatGPT がそれぞれ採点し平均。5つの問いに一目で答えられるか(各8点)、大事な数字の位置・1画面に収まるか・色・単位・題名(各5点) |
| 数字の正しさ | 20 | 売上・原価・粗利・店舗順位を、別に集計した正解値と突き合わせる |
| 使いやすさ | 15 | 閲覧モードで絞り込みを実際に操作し、全チャートが連動するか |
2つのAIの見た目の点は、相関0.86でほぼ同じ並びでした。ChatGPT のほうが平均で3点ほど厳しめです。
作業時間と使用量(トークン数)は、Claude Code の作業記録から測りました。画面はすべて録画しています。
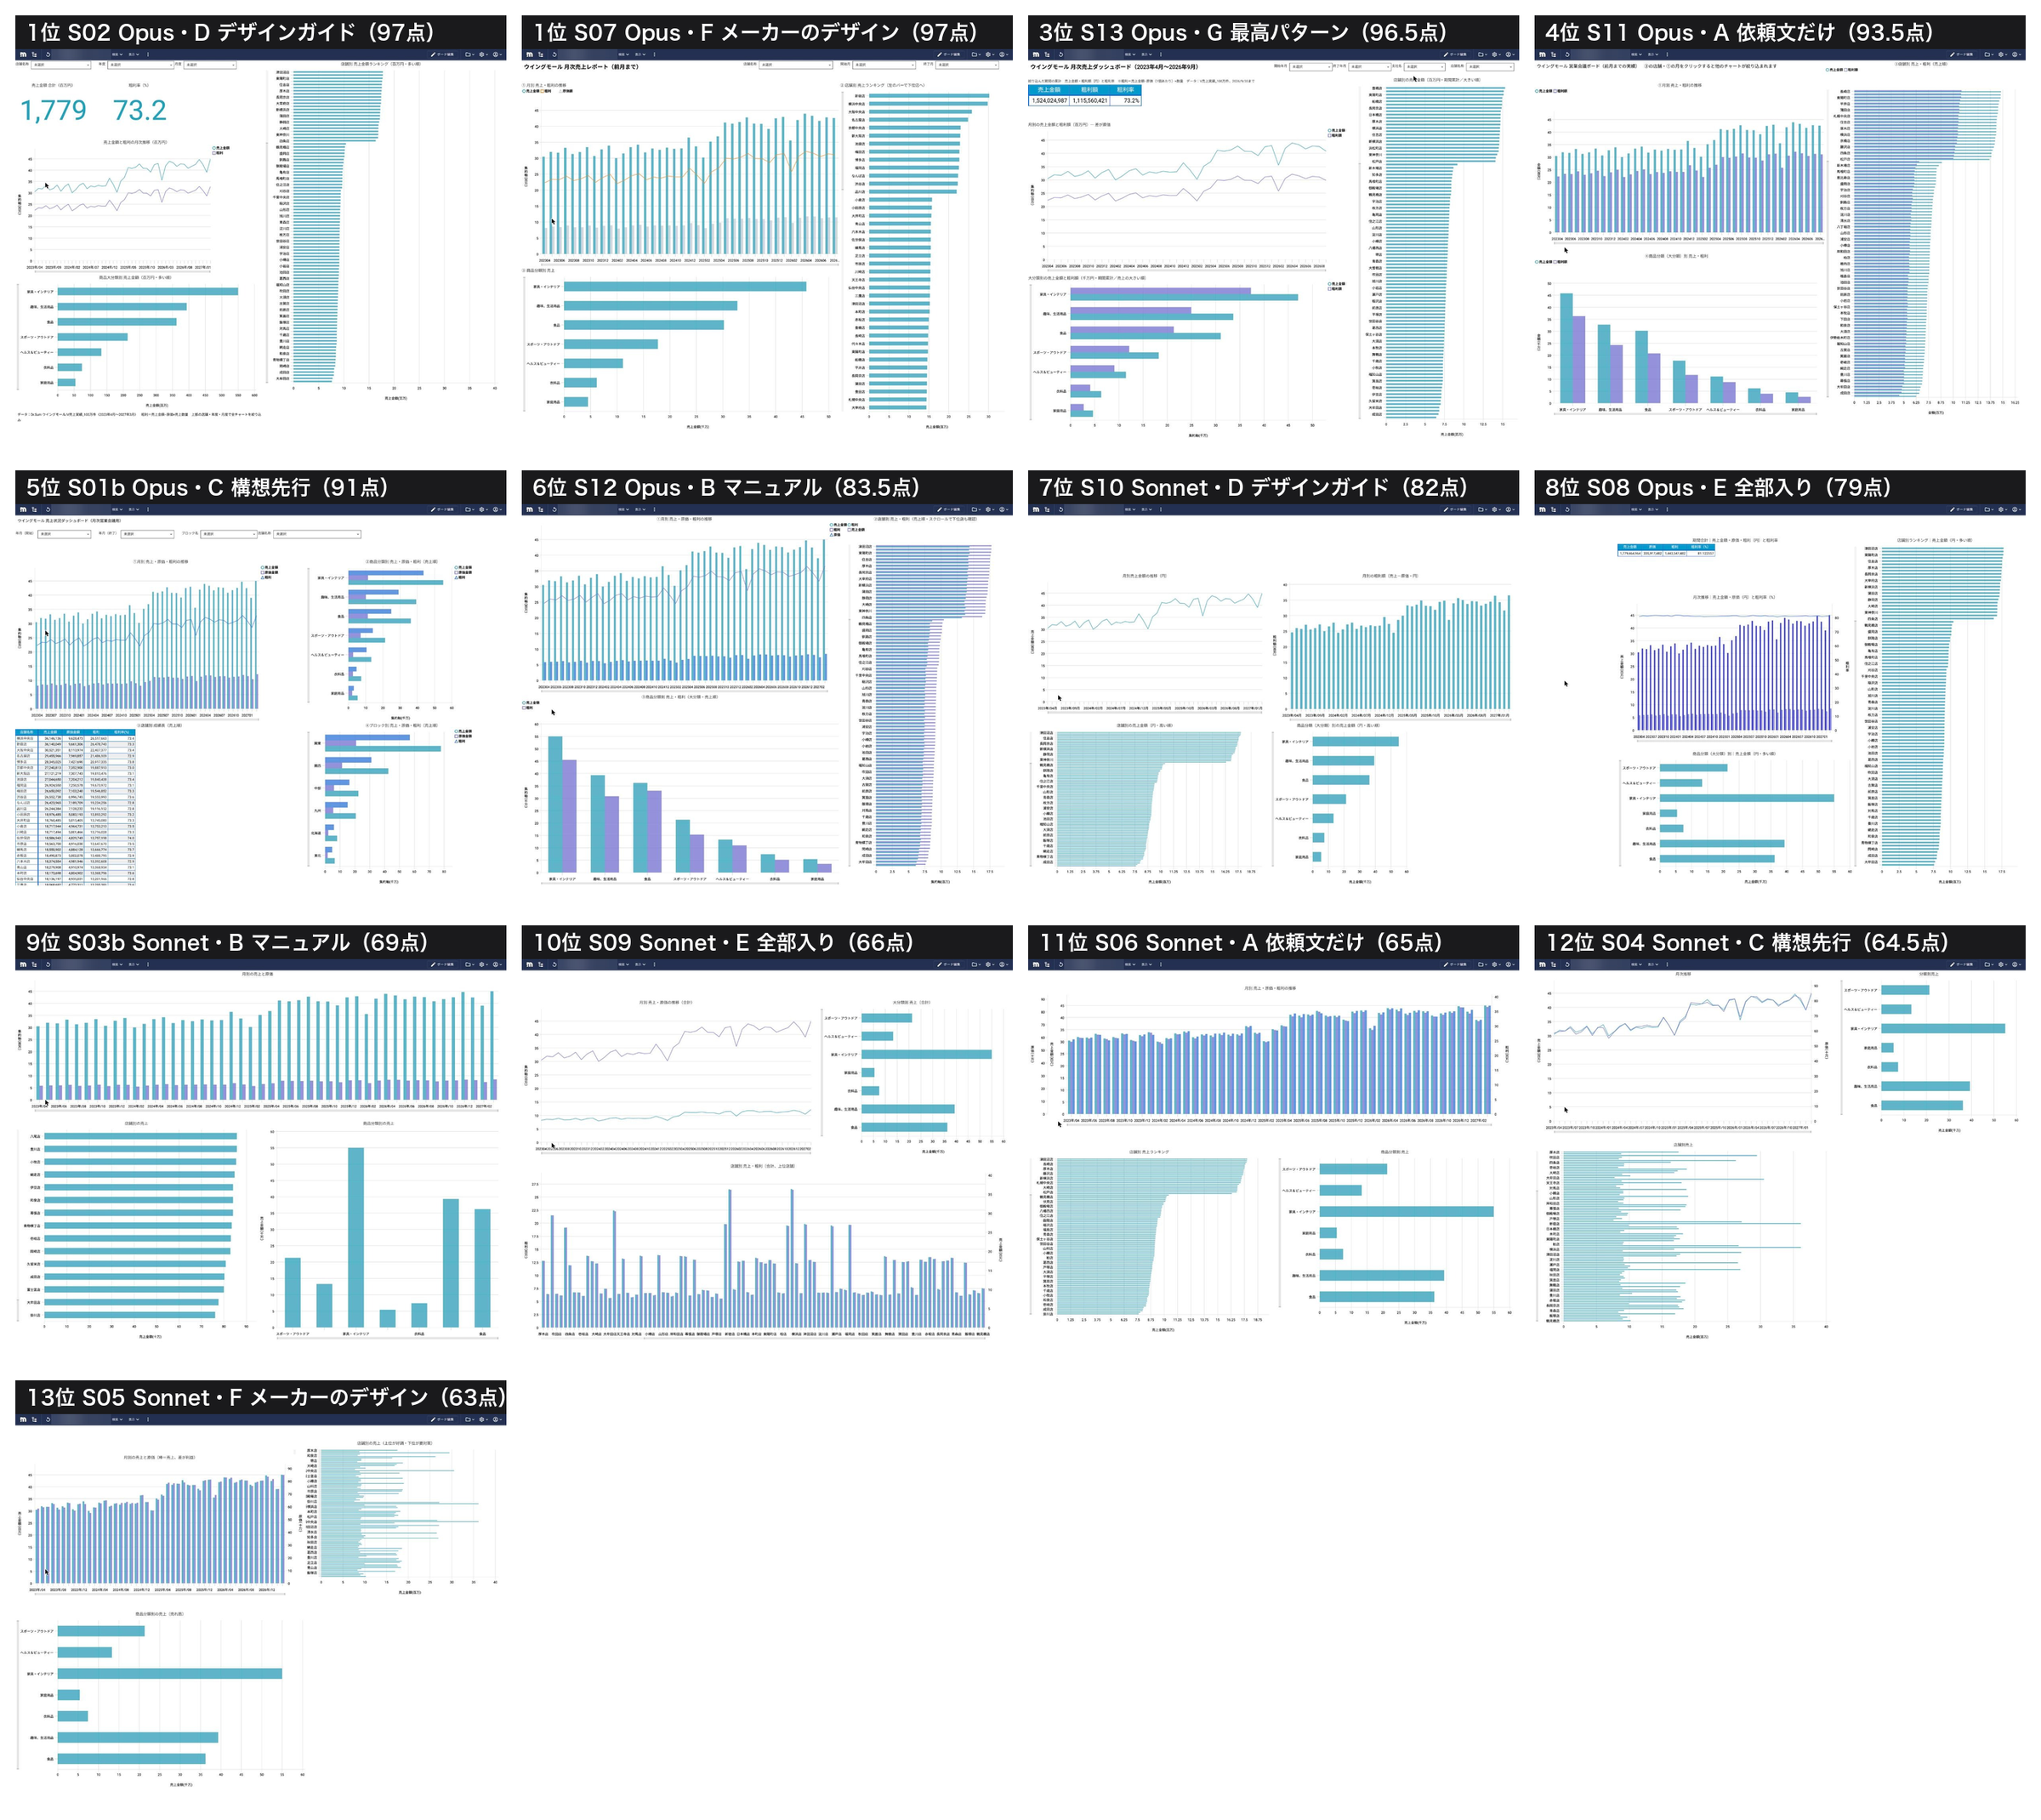
| 順位 | 回 | モデル | 条件 | 合計 | 見た目 | 正しさ | 使いやすさ | 作業時間 |
|---|---|---|---|---|---|---|---|---|
| 1 | S02 | Opus | D デザインガイド | 97 | 62 | 20 | 15 | 34分 |
| 1 | S07 | Opus | F メーカーのデザイン | 97 | 62 | 20 | 15 | 27分 |
| 3 | S13 | Opus | G 最高パターン | 96.5 | 61.5 | 20 | 15 | 44分 |
| 4 | S11 | Opus | A 依頼文だけ | 93.5 | 60.5 | 20 | 13 | 32分 |
| 5 | S01b | Opus | C 構想先行 | 91 | 56 | 20 | 15 | 31分 |
| 6 | S12 | Opus | B マニュアル | 83.5 | 56.5 | 12 | 15 | 27分 |
| 7 | S10 | Sonnet | D デザインガイド | 82 | 55 | 12 | 15 | 17分 |
| 8 | S08 | Opus | E 全部入り | 79 | 52 | 12 | 15 | 20分 |
| 9 | S03b | Sonnet | B マニュアル | 69 | 44 | 12 | 13 | 14分 |
| 10 | S09 | Sonnet | E 全部入り | 66 | 45 | 16 | 5 | 17分 |
| 11 | S06 | Sonnet | A 依頼文だけ | 65 | 42 | 12 | 11 | 12分 |
| 12 | S04 | Sonnet | C 構想先行 | 64.5 | 42.5 | 8 | 14 | 15分 |
| 13 | S05 | Sonnet | F メーカーのデザイン | 63 | 44 | 8 | 11 | 11分 |
A〜F の6条件で比べると、Opus 5.5 の平均は90.2点、Sonnet 5.5 は68.3点でした。Sonnet の最高(82点)は、Opus の6回のうち下から2番目(83.5点)に届きません。
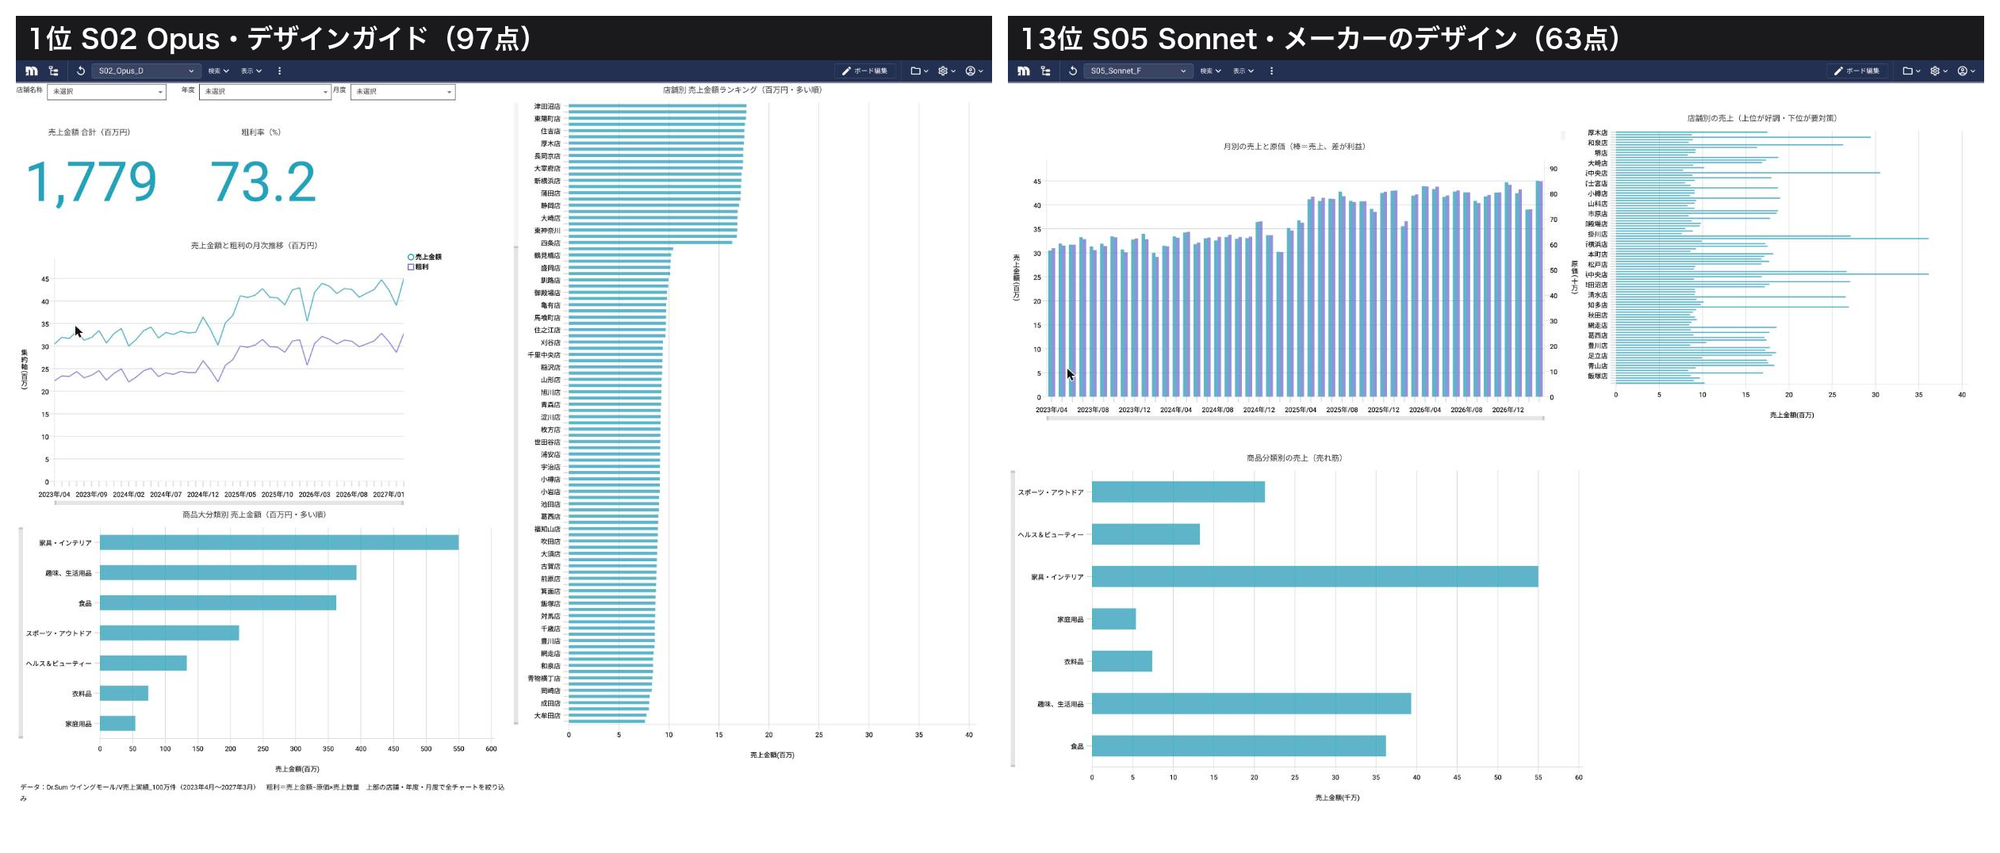
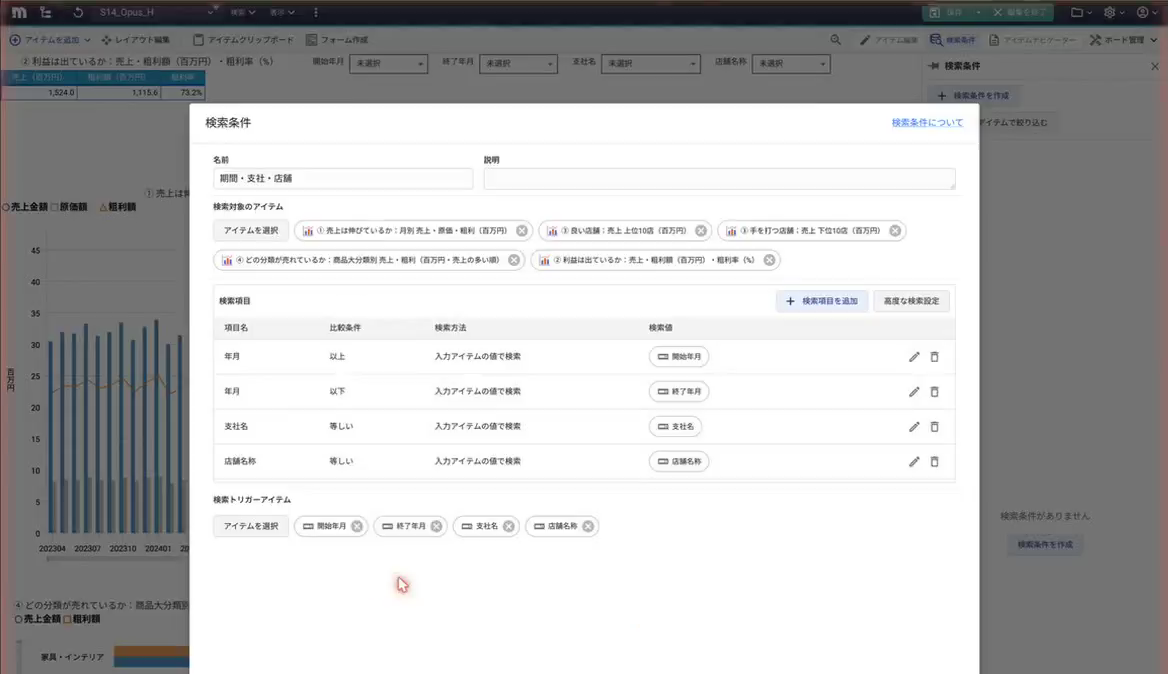
上位の回はどれも、左上に売上合計と粗利率の大きな数字、上部に期間・店舗の選択欄、推移・店舗順位・分類のチャートがそろっています。下位の回は、店舗130店を1本の棒に並べて店名が読めない、単位がチャートごとに違う、絞り込みの入口が画面に無い、のどれかが残っていました。
作ったあとの見直しにも差がありました。Opus は完成後に閲覧モードで開き、はみ出しや並び順を直す「手直し」の時間を6回平均で約3分取っていました。Sonnet は記録のある4回の平均が約1分で、手直しの時間が0分の回もありました。
| 条件 | Opus | Sonnet |
|---|---|---|
| A 依頼文だけ | 93.5 | 65 |
| B マニュアル | 83.5 | 69 |
| C 構想先行 | 91 | 64.5 |
| D デザインガイド | 97 | 82 |
| E 全部入り | 79 | 66 |
| F メーカーのデザイン | 97 | 63 |
どちらのモデルでも、デジタル庁のガイドブックを渡した回(D)が最高点でした(Opus は F と同点)。「大事な数字は左上」「色は意味のあるものだけ」「チャートの題名は問いにする」といった考え方が、そのまま画面に表れています。
一方、資料を全部渡した回(E)は、Opus でも Sonnet でも D を大きく下回りました。準備(資料を読み、データを確かめる段階)の時間は D の回の約6倍で、組み立ての時間は両モデルとも D の回より短くなっています。マニュアル(B)は、依頼文だけ(A)と比べて Opus で10点低く、Sonnet で4点高い結果でした。Opus の B 回は、後で書く原価の読み違いで数字の正しさを落としています。
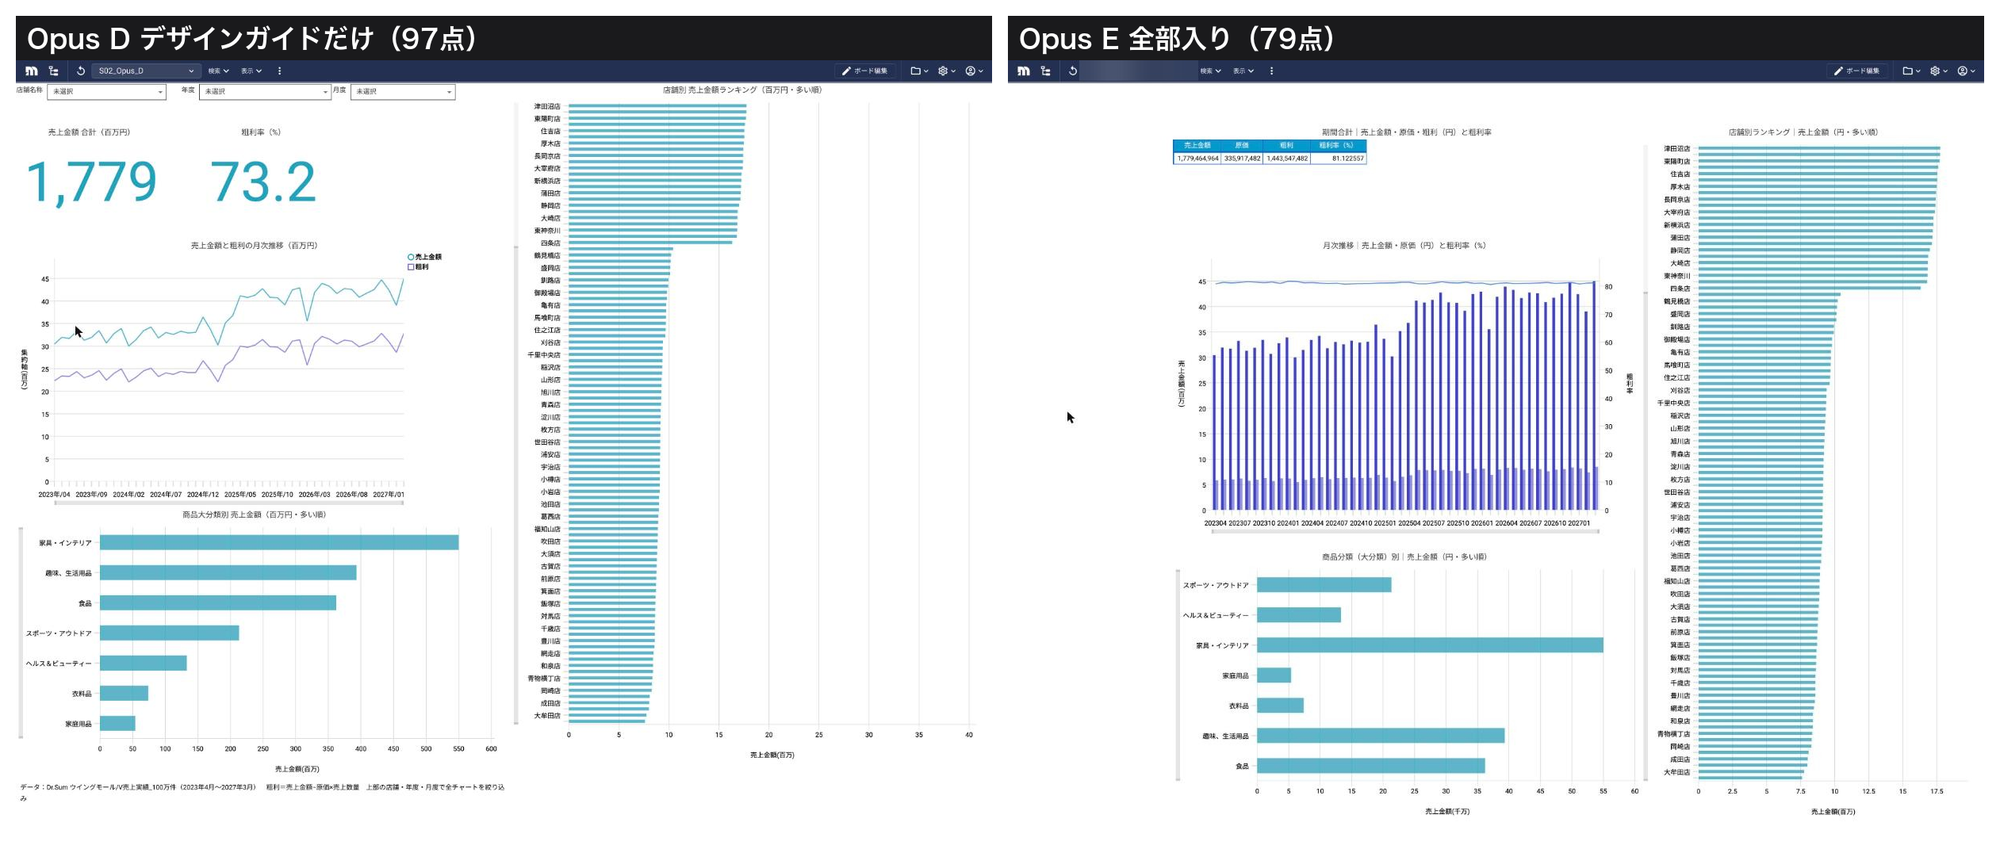
条件ごとに1回ずつの比較なので、もう一度やったときにどれだけ点が動くかは分かりません。それでも「ガイドブックの回が最高、全部入りはそれを下回る」という並びは、2つのモデルで同じでした。
このデータには、気づかないと数字を誤る点が2つあります。
1つ目は原価です。「原価」の項目は1個あたりの金額で、売上数量を掛けないと原価額になりません。そのまま合計すると粗利率は81%と出ます。正しくは約73%です。これに気づいたのは13回中6回で、Opus が5回、Sonnet は1回でした。
2つ目は未来の月です。データには、今日より先の月の売上が入っています。お題は「前月までの売上の状況」なので、当月より前に絞る必要があります。4位の回(S11)は、MotionBoard のシステム変数「当月」を使って自動で絞っていました。
数字の正しさで満点を取ったのは Opus の5回だけです。見た目がきれいでも、粗利率が81%と出ている画面は会議で使えません。
| A〜F の6回の平均 | Opus 5.5 | Sonnet 5.5 |
|---|---|---|
| 作業時間 | 28分 | 14分 |
| 読み込んだ量 | 約4,900万トークン | 約2,700万トークン |
| 道具の使用回数 | 172回 | 288回 |
| 点数 | 90.2点 | 68.3点 |
Sonnet は Opus の半分の時間で終わり、読み込んだ量も半分強です。一方で道具の使用回数(クリックや画面の写真など)は、Sonnet のほうが平均で7割ほど多くなっています。
AI は1手ごとに、それまでの作業の記録を読み直しながら進みます。作業が長い回ほど読み込んだ量は大きく、予算比較まで足した S16(74分)は1回で約1億3,000万トークンでした。
ここからは比較の外で、どこまで良くできるかを試しました。
13回の点数と採点者の指摘、つまずいた操作をまとめた教材を作り、Opus に渡して作り直しました(S14)。結果は Claude・ChatGPT とも見た目65点満点、数字と絞り込みも満点で、100点です。作業時間は48分でした。
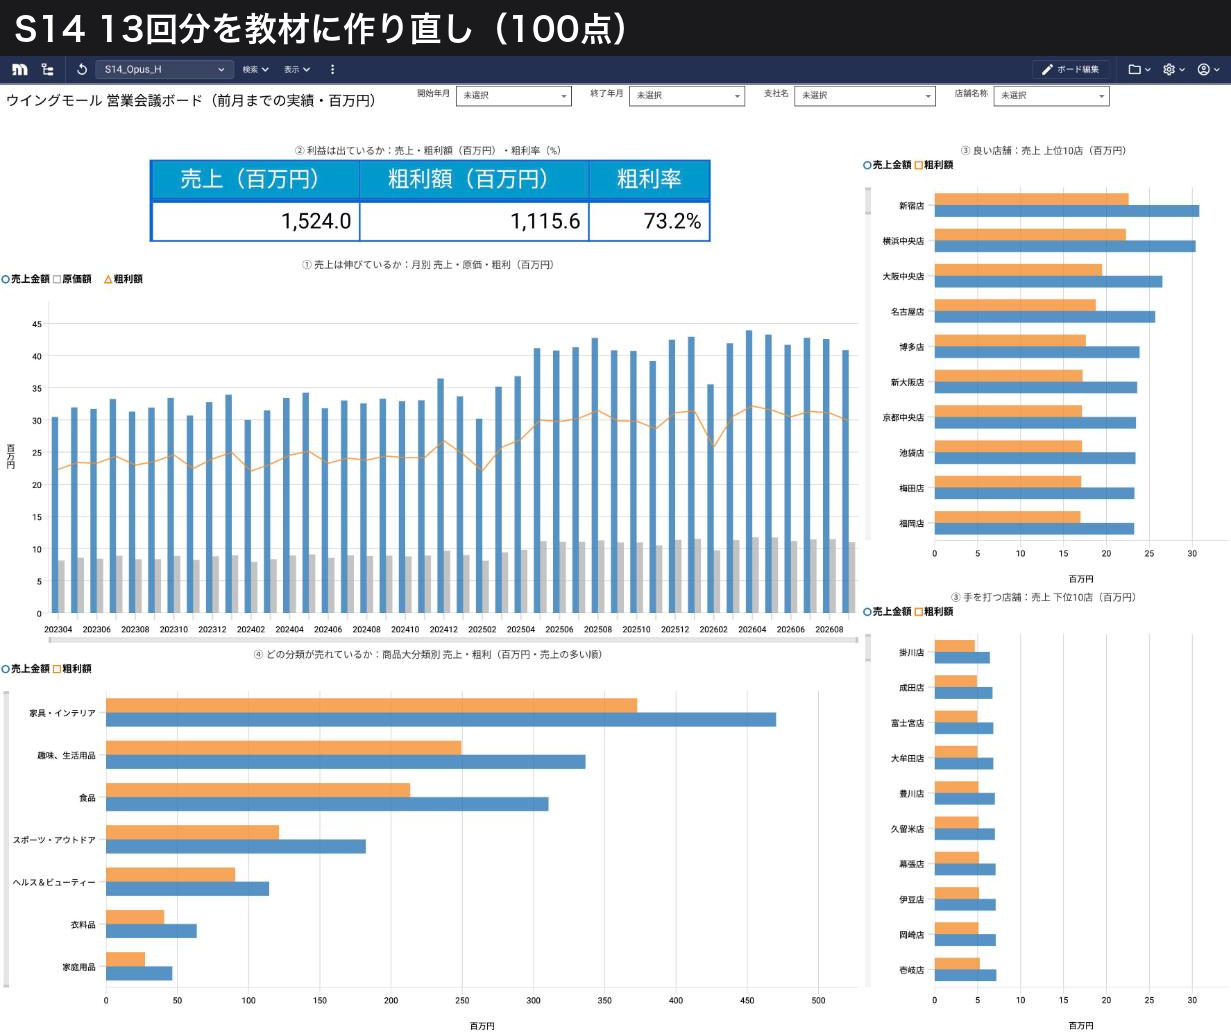
教材に書いたのは、たとえば次のような点です。
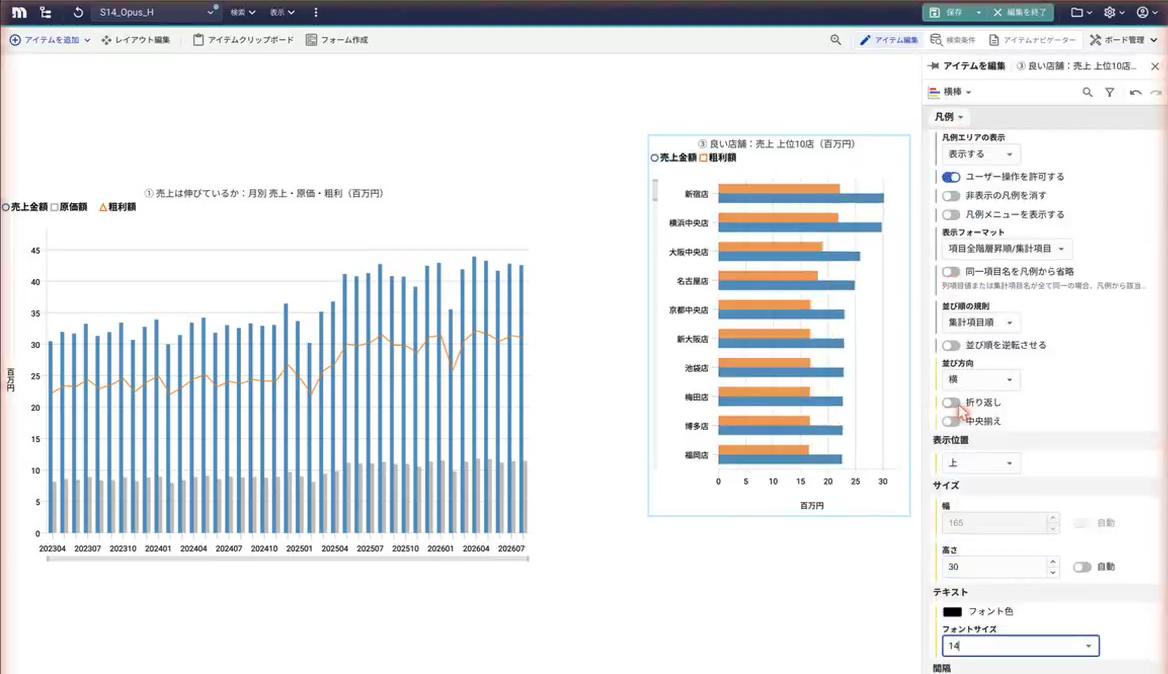
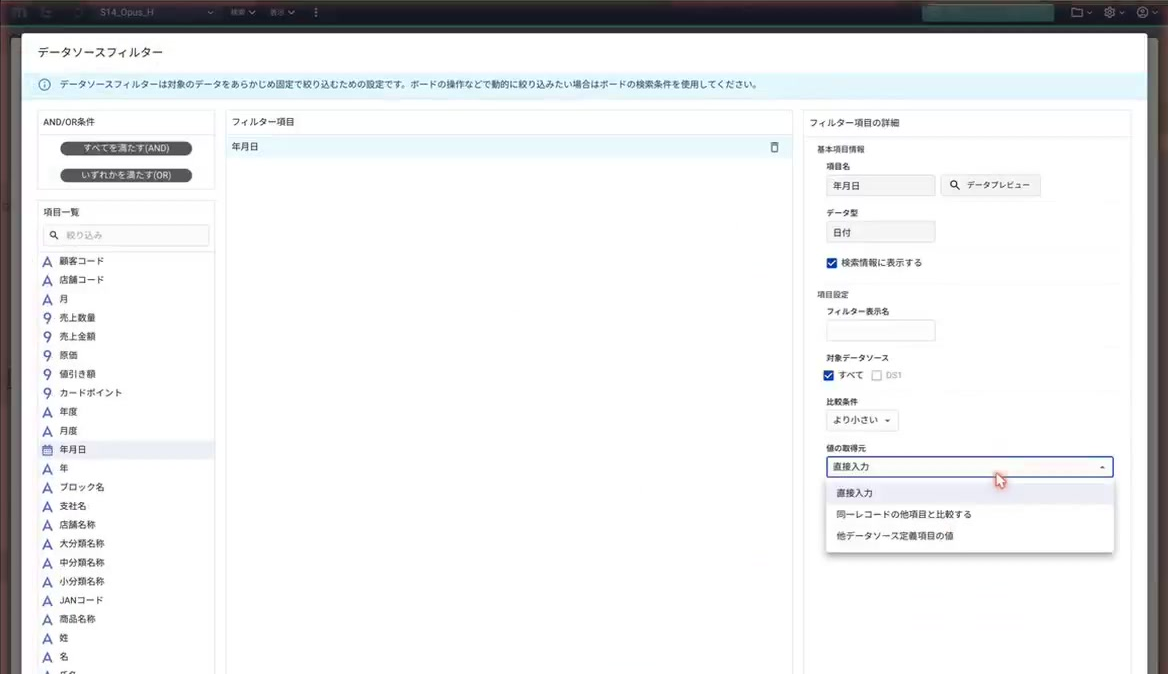
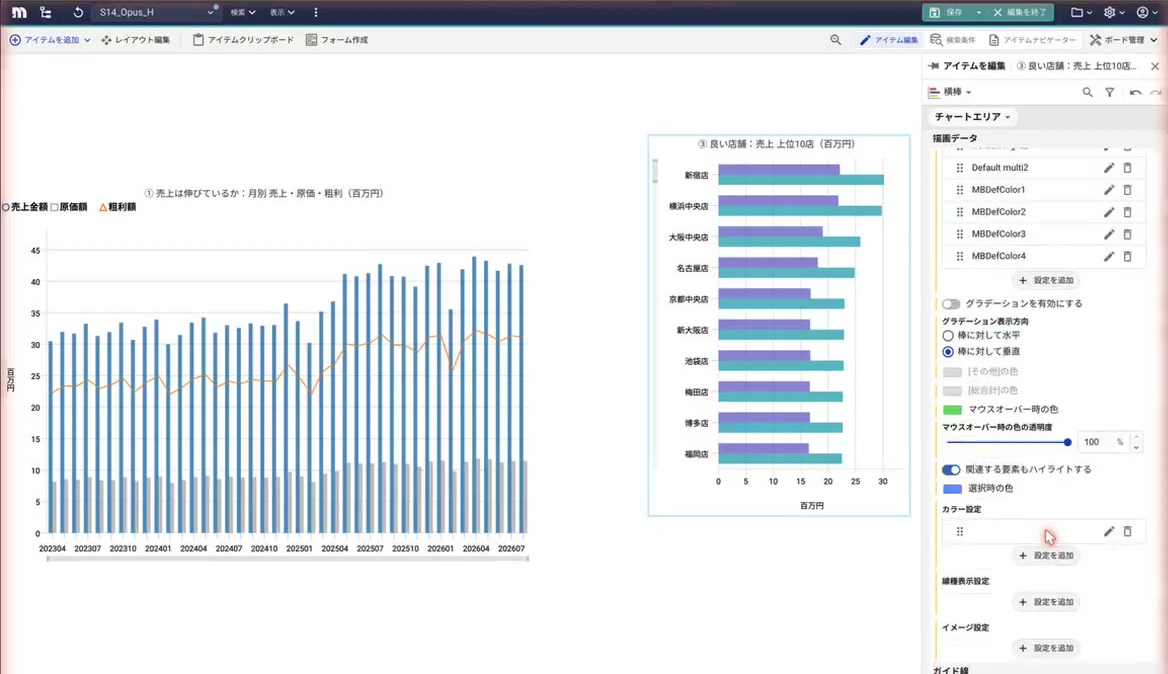
3つ目は、多くの回でつまずいた点です。MotionBoard ではデータソースの定義を複数のチャートで使い回せます。AI は使い回していることに気づかないまま1枚の行や列を変え、ほかのチャートまで書き換えていました。
続けて、色の組み合わせ(紺・グレー・オレンジの3色)と余白の決まりを渡し、見た目だけを仕上げました(S15)。
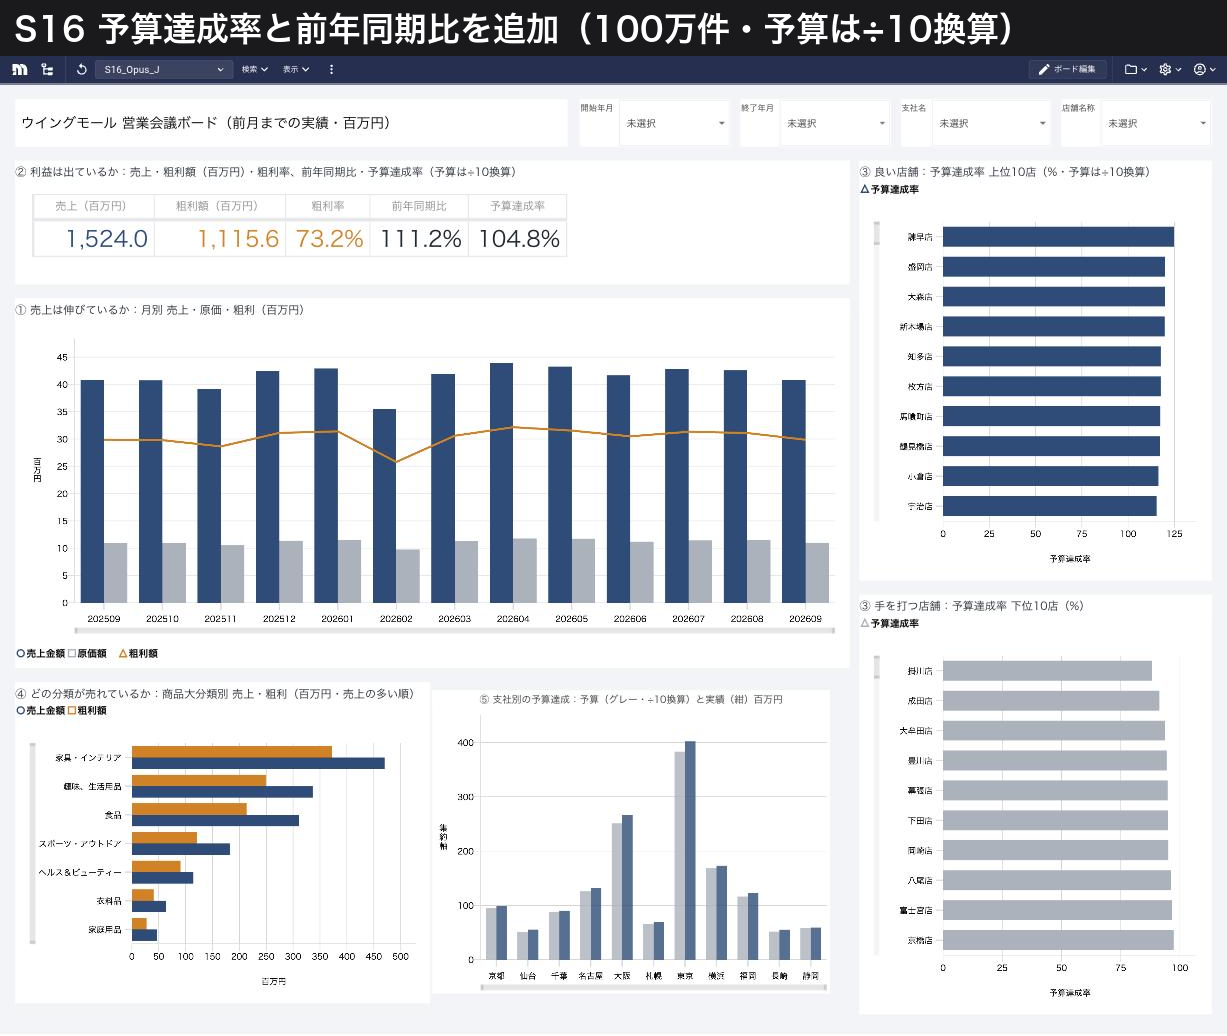
営業会議では「予算に届いているか」「前年より伸びているか」が欠かせません。S15 をコピーし、予算達成率と前年同期比を足す指示を出しました(S16)。
ここで AI は、予算の表と売上実績の大きさが合わないことに気づきました。調べた結果、使っていた売上実績(100万件)は、同じデータベースにある全件の売上実績(1,000万件)のちょうど10分の1で、予算は全件の大きさで作られている、と自分で突き止めています。指示では100万件のデータを使うよう決めていたので、AI はデータを切り替えず「予算を10分の1にして比べる」と判断し、画面にもそう注記しました。
そこで、全件のデータに切り替えて作り直しました(S17)。
| 100万件(予算÷10) | 全件(1,000万件) | |
|---|---|---|
| 粗利率 | 73.2% | 73.2% |
| 前年同期比 | 111.2% | 112.0% |
| 予算達成率 | 104.8% | 105.4% |
| 達成率の高い店1位 | 諫早店 | 一宮店 |
売上は全件でほぼ10倍になり、粗利率は同じ、前年同期比と予算達成率の差は1ポイント未満でした。ところが店ごとの予算達成率の順位は大きく変わりました。1位の店が入れ替わり、100万件のデータで下位3番目だった店が、全件では上位10店に入っています。今回のデータでは、10分の1の抜き出しで全体の率はほぼ合っても、店ごとの順位は全件と合いませんでした。
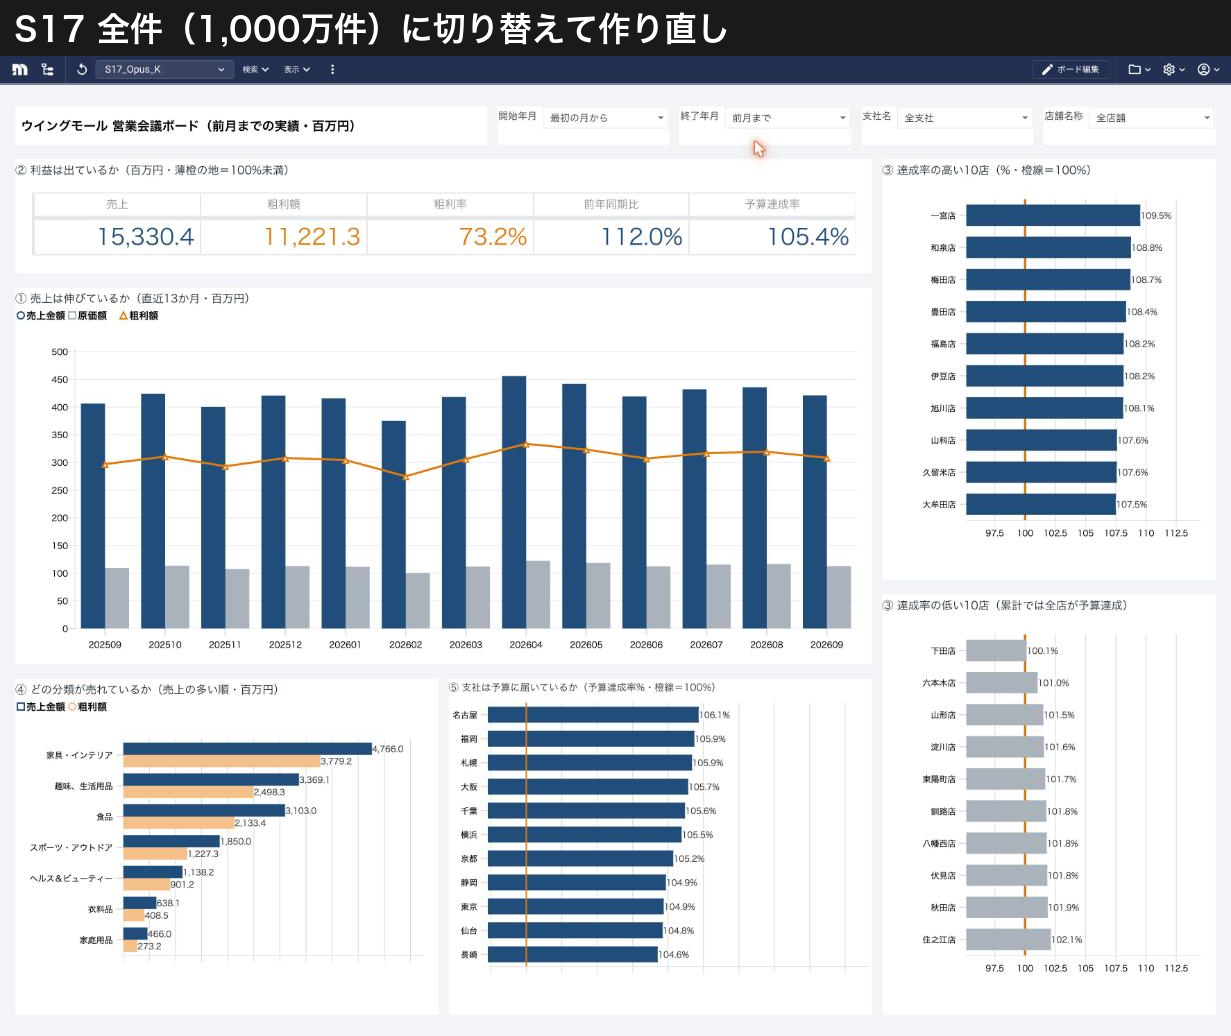
S17 では、比べる数字の色分け、支社ごとの達成率と100%の線、推移を「当月から直近13か月」に自動で絞る設定も入れています。この回は作業が長くなりました。1回目は実際には46分しか経っていないのに、AI が「時間の上限の120分を使い切った」と報告して止まったため、3回に分けて続けています。合計で約3時間です。
13回の録画を見ると、つまずく箇所はほぼ決まっていました。
どれも、一度分かれば次からは迷わない種類のものです。S14 の教材には、これらの操作のコツも書いています。
Q. 人は何をしたのですか?
A. 比較の13回では、MotionBoard へのログインだけです。パスワードは AI に渡さず、人が入力しました。作業中の助言や手直しはしていません。S14 以降は、教材や直す点の一覧を人が用意して渡しています。
Q. 自社のデータでも同じようにできますか?
A. 今回の結果は、項目名が分かりやすいサンプルデータでのものです。「原価が1個あたり」のような項目の意味は、データを見ただけでは分からないこともあります。項目の意味を書いたメモを一緒に渡すと、読み違いは減ると考えています。